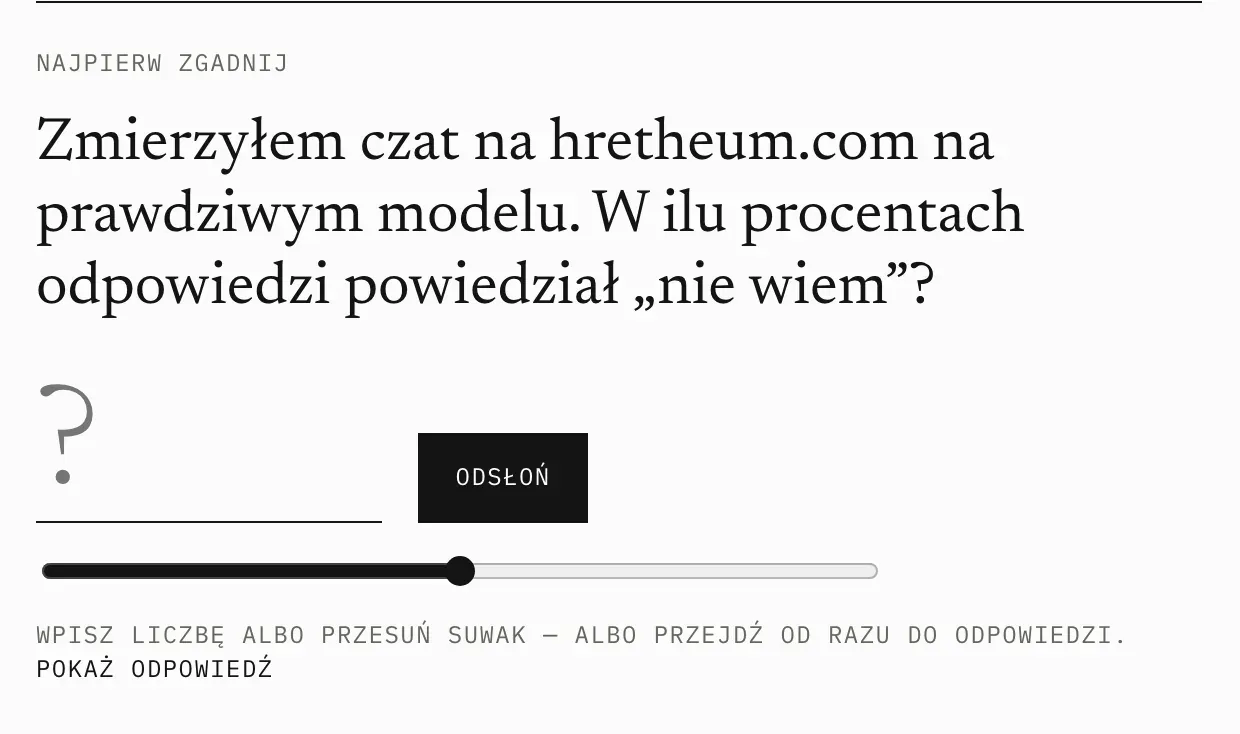
Zanim zaczniesz czytać, spróbuj zgadnąć. Moja strona ma czat, który odpowiada tylko na podstawie mojego profilu. Zmierzyłem go na prawdziwym modelu. W ilu procentach odpowiedzi czat powiedział „nie wiem”? Wybierz liczbę.
Odpowiedź: w 3,3 procentach. Czat nie podał też żadnego faktu spoza profilu, a najwolniejsze 5 procent odpowiedzi trwało 9,5 sekundy. Te zdania pochodzą z mojego profilu i mają przypisaną datę pomiaru, 13 października. To tylko jeden z możliwych przykładów zestawienia faktu z tym, czego odbiorca się spodziewał.
W ten sam sposób działa lekcja 2.1 na mojej stronie dla rekrutera. Jest pole na liczbę, a obok suwak. Przycisk „Odsłoń” pokazuje odpowiedź, a zdanie pod spodem mówi: „albo przejdź od razu do odpowiedzi”.
Dla osoby, która czyta piąte CV tego dnia
Zbudowałem tę stronę, żeby osoba prowadząca rekrutację, która czyta piąte CV tego dnia, miała szansę obudzić się przy moim profilu. Zamiast pasywnej nudy lektury pliku PDF chciałem wciągnąć ją w zaangażowanie, co wydaje mi się dobrą metodą przyswajania wiedzy.
Pomysł z początku października był prosty: strona pod ogłoszenie jako krótki kurs o mnie. Aplikacje typu ATS są zorientowane na wydajność, skracając czas obsługi do minimum. Nauka działa odwrotnie, zatrzymuje uwagę i każe wykonać pożądane akcje. Notatka zapisana ręcznie zostaje w głowie dłużej niż przeczytana. Forma ma być też dowodem moich kompetencji: tak projektowałbym naukę w platformach e-learningowych.
Kurs trwa około sześciu minut i ma dziewięć punktów na pasku postępu, czyli osiem lekcji i zaliczenie. Zgadujesz liczbę, zanim ją zobaczysz. Uzupełniasz zdanie z luką. Po krótkim sprawdzianie dostajesz wyjaśnienie z cytatem ze źródła. Zapisujesz notatki, które zostają w twojej przeglądarce. Na końcu piszesz jednym zdaniem, co o mnie wiesz, jakbyś mówił to przełożonemu, i dostajesz zaświadczenie. Stoi na nim, że to nie jest akredytowana kwalifikacja i że zaświadcza tylko, że wiesz teraz o mnie więcej niż większość rekruterów.
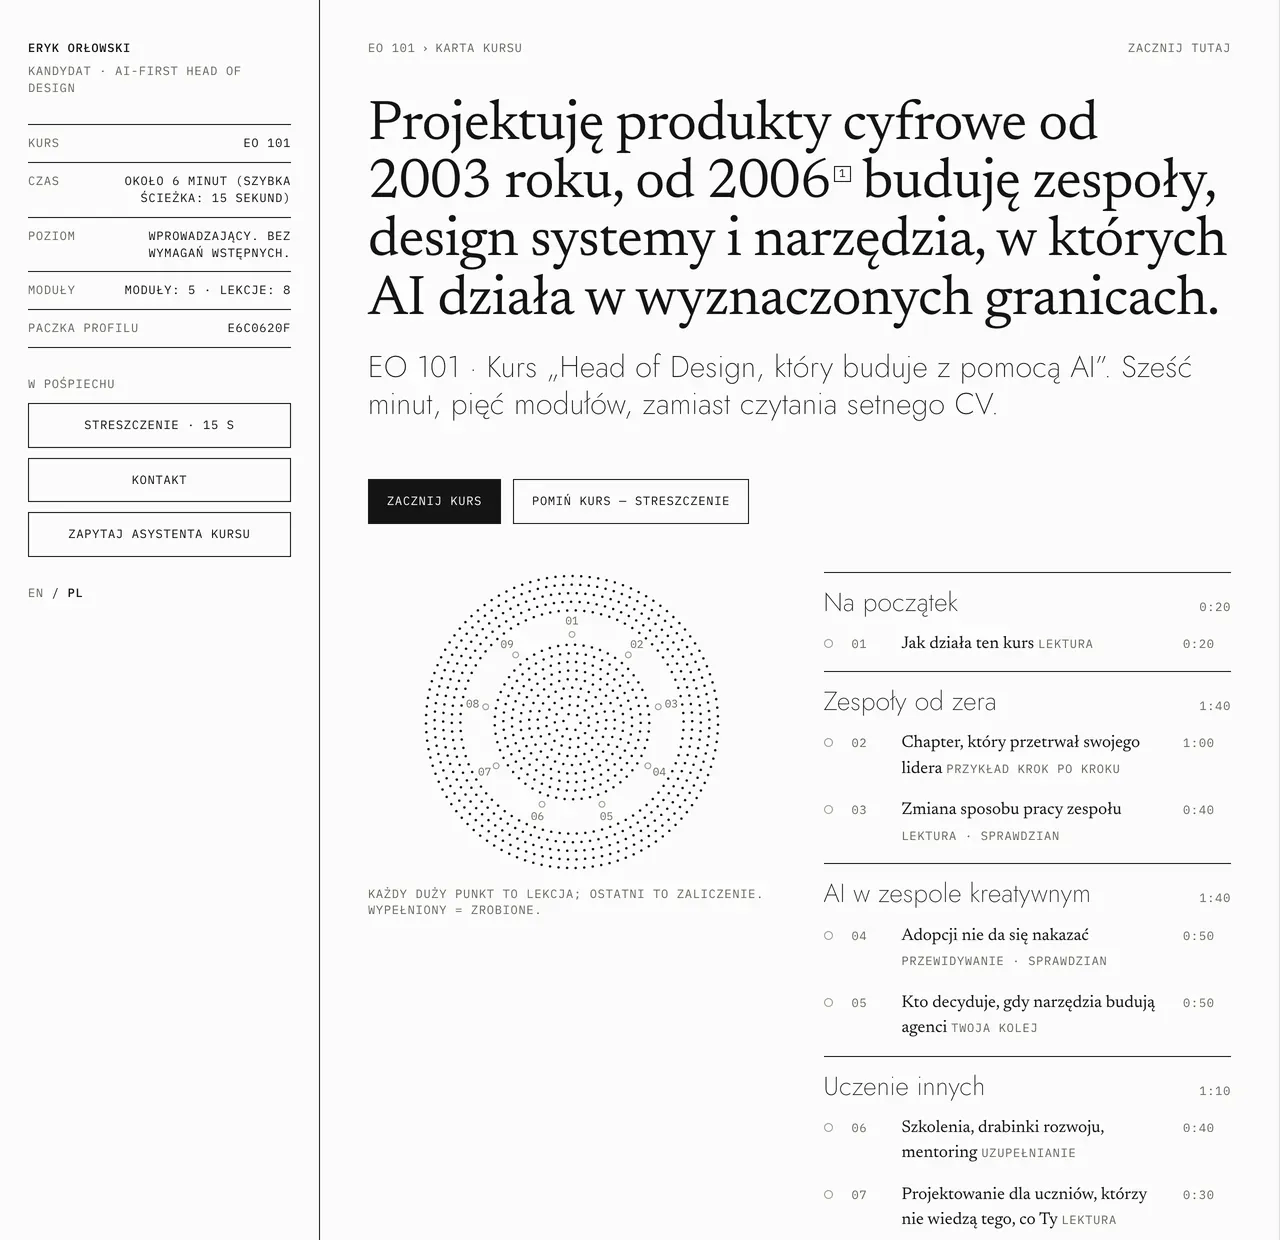
Elementy platformy i mechanizmy uczenia rozpisał agent AI, a ja zatwierdziłem kurs jako domyślne wejście na stronę. Koncepcja miała dwa twarde warunki. Metafora ma być czytelna w pięć sekund dla kogoś, kto nigdy nie projektował nauki, więc strona używa znaków znanych z platform e-learningowych. I szybki pas: teza w jednym zdaniu oraz przyciski do CV i kontaktu są widoczne na każdym ekranie, a żaden fakt nie czeka za ćwiczeniem. Kurs jest zaproszeniem. Nikogo nie zatrzymuje.
Dwa dni od pomysłu do produkcji
Resztę zrobiły agenty AI, a ja podejmowałem decyzje.
Najpierw wygląd. Mój program Gatefold, w którym agenci projektują ekrany, przygotował wcześniej 12 typowych wzorców ekranów kursu. Zakładały 12 lekcji w czterech modułach, a mój kurs miał osiem lekcji w pięciu. Uznałem, że ważniejsza jest treść, więc ekrany dopasowano do ośmiu lekcji.
Potem kod, zbudowany przez agenta, według zlecenia z moich notatek. Drugi agent sprawdził całość. O wdrożeniu zdecydowałem ja, choć jedna automatyczna kontrola świeciła na czerwono. To kontrola, która porównuje wygląd strony z poprzednią wersją. Czerwień wzięła się stąd, że po obu stronach porównania były inne dane o moim profilu. Przy tych samych danych różnic nie było. 10 października kurs działał na produkcji.
Zaraz potem zgłosiłem trzy poprawki.
Pierwsza dotyczyła imienia. Po wygenerowaniu zaświadczenia o ukończeniu kursu tekst się nie zmieniał, a PDF wychodził bez personaliów. Aplikacja wyszukiwała anglojęzyczne wzorce językowe, co nie chciało działać w polskim wariancie.
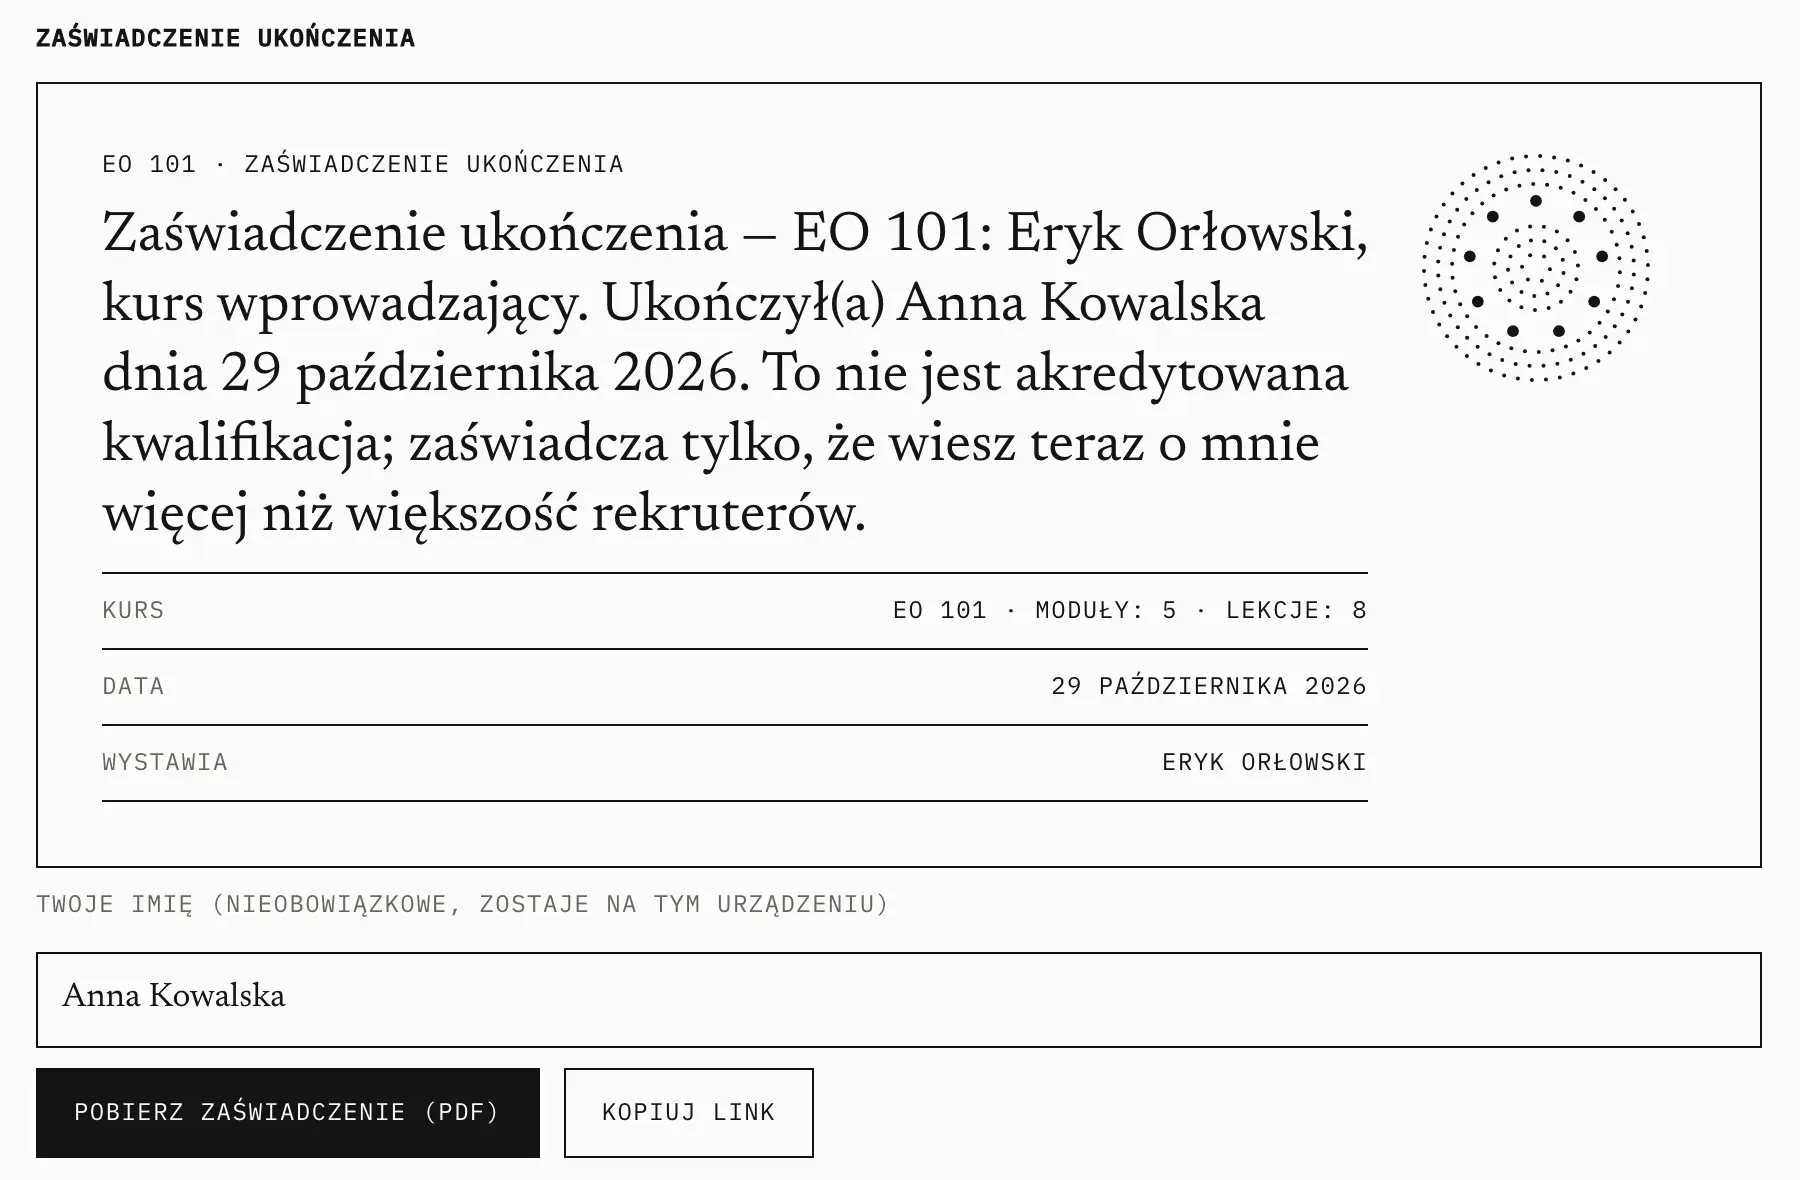
Druga dotyczyła polskich znaków diakrytycznych w tym samym PDF. Najpierw uznałem, że ł zamienione na l może zostać. Dzień później PDF dostał odpowiednie fonty i polskie znaki wróciły.
Trzecia dotyczyła odnośnika do asystenta. Gdyby taki link sam wysyłał pytanie, ktoś mógłby podrzucić odwiedzającemu spreparowany link. Zużyłby on limit pytań odwiedzającego i kosztował mnie płatne odpowiedzi modelu. Teraz pytanie wysyła się samo tylko wtedy, gdy ktoś kliknie podpowiedź na stronie.
Czy kurs pomaga w rozmowie z HR, tego w tym tekście nie mierzę (chyba że zacznę). Kurs liczy tylko zbiorcze zdarzenia, na przykład ukończoną lekcję i zaliczenie, i tylko wtedy, gdy odwiedzający się na to zgodzi.
Luki mają być widoczne
Kurs ma dwie reguły, które nie dotyczą nauki. Po pierwsze, nic nie trafia na produkcję bez potwierdzenia: każdy fakt ma źródło z cytatem, a niepotwierdzony nie przejdzie kontroli, którą strona przechodzi, zanim trafi do sieci. Po drugie przejrzystość: strona pokazuje wymagania, których nie spełniam. Na jednej z prawdziwych stron ta sama kontrola wykazała pokrycie 18 z 20 wymagań i wprost wymieniła braki.
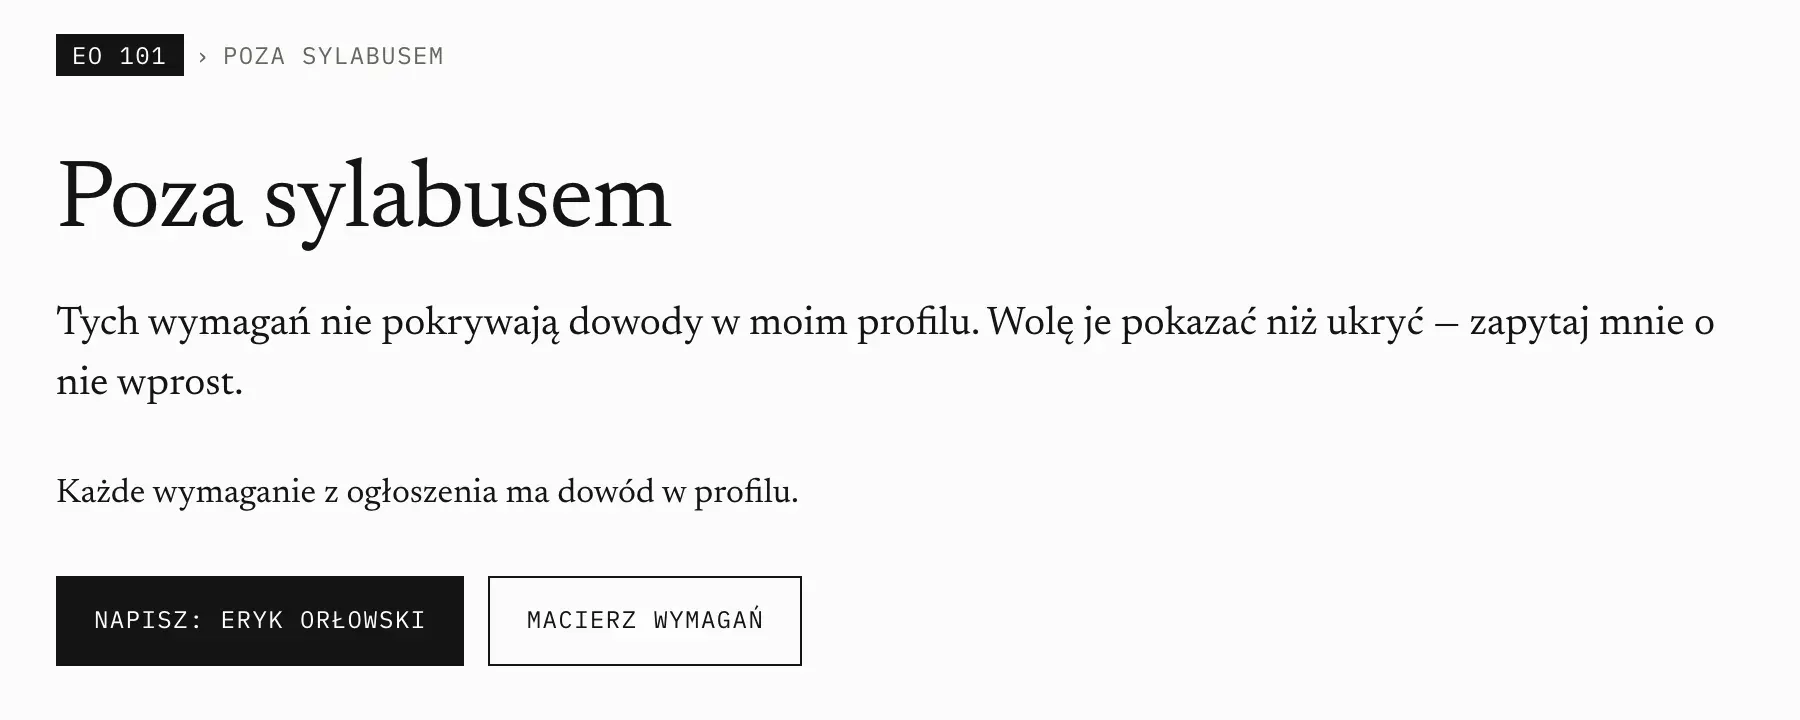
Publiczne demo, eo101.hretheum.com, nie może używać prawdziwego ogłoszenia, więc zostawiłem w nim dane ogólne, ułożone z pozycjonowania mojego profilu: dziewięć wymagań i pięć obowiązków dla roli „AI-first Head of Design”. Otwieram w nim stronę „Poza sylabusem”. Nad pustym miejscem stoi zdanie: „Tych wymagań nie pokrywają dowody w moim profilu. Wolę je pokazać niż ukryć.” Pod nim drugie: „Każde wymaganie z ogłoszenia ma dowód w profilu.”
Przejdź kurs: eo101.hretheum.com. To około sześć minut.
Szkic przygotowały agenty AI, a redakcję i sprawdzenie faktów zrobiłem ja.
Za kulisami tego tekstu
Każdy wpis w Experiments przechodzi przez serię kontroli, zanim trafi do czytelnika, i ten też. Poniżej widać je po kolei: co robię na danym etapie, przed jakim ryzykiem to chroni i co wyszło w tym tekście. Na końcu jest ramka o narzędziu do pilnowania języka, które wymyślił ktoś inny.
- Teza i powód pisania. Zanim powstanie szkic, zapisuję jednym zdaniem tezę, odpowiedź na pytanie „dlaczego teraz” i zdanie zaczynające się od „Piszę to, bo…”, w którym jest coś, co mnie zaskoczyło, kosztowało albo zmieniło moje zdanie. Chroni to przed tekstem napisanym dlatego, że wypada coś napisać. Tu powód to osoba, która czyta piąte CV tego dnia, i moja chęć, żeby miała szansę obudzić się przy moim. Pierwsza wersja miała inną tezę, o pustej liście braków na demo. Zmieniłem ją po przeczytaniu szkicu, bo nie to było celem kursu. Ta pierwsza teza została w tekście jako jeden epizod.
- Czy to nie jest znów ten sam tekst. Zanim zacznę redagować, porównuję szkic z ostatnimi tekstami z bloga i z kolejki. Patrzę na to, jak się otwierają, ile mają śródtytułów i jakich, jak długie są części i jak się kończą. Jeśli szkic powtarza wzór poprzedniego, zmieniam formę albo wyjaśniam, dlaczego zostaje. Forma ma wynikać z materiału, szablonu nie ma. Zasada wzięła się z mojej uwagi z 5 października 2026: stała struktura daje nudne, identyczne teksty. Nie mam do tego programu, porównanie robi agent i ja, na piśmie. To nie to samo co kontrola rytmu zdań w etapie szóstym. Tutaj oceniam budowę całego tekstu, tam pojedyncze zdania, ich powtarzalny szyk i nawał łączników. Obie rzeczy bywają nazywane monotonią, a łapią co innego.Wynik dla tego tekstu jest mieszany. Wejście różni się od poprzednich: zamiast sceny czy wyznania jest pytanie do czytelnika z liczbą do odgadnięcia. Mniej śródtytułów (trzy wobec czterech lub pięciu w ostatnich wpisach) i krócej (około 700 słów wobec 800 do 900). Środek, część o dwóch dniach budowy, to jednak znów sprawozdanie w kolejności prac, jak w kilku ostatnich tekstach. Zakończenie, dwa krótkie zdania obracające cytat ze strony, przypomina zakończenie szkicu o dniu, w którym strona zderzyła się z moim profilem. Uznałem, że różni je wystarczająco wejście i oś tekstu. Jeśli następny tekst znów zacznie się od sprawozdania, przepisuję środek.
- Szkic piszą agenty. Agent AI pisze pierwszą wersję wyłącznie z dokumentów i historii zmian w repozytorium. Ryzyko to zmyślony fakt albo zmyślone uczucie. Dlatego brakujący fakt dostaje znacznik zamiast domysłu, a tekst ze znacznikiem nie idzie dalej. W tym tekście jedyna wypowiedź o moich motywach pochodzi z mojej własnej uwagi do pierwszej wersji szkicu. Agent niczego nie dopisał od siebie. Nie podaje też daty startu publicznego dema, bo jej w materiałach nie ma.
- Czy technika została w ramkach. Prosty skrypt wycina ramki „Tech deep dive” i szuka w reszcie żargonu, na przykład nazw narzędzi i formatów. Chodzi o to, żeby tekst główny dało się przeczytać bez ramek. W tym tekście skrypt nie znalazł nic poza ramkami: opis parsera, model dopasowania i pliki nakładek siedzą w ramkach.
- Czytelnik z zewnątrz. Drugi agent czyta tekst bez ramek jak szef produktu w firmie, która buduje coś z AI. Wskazuje zdania, których nie rozumie, miejsca bez decyzji lub liczby, akapity, przy których się nudzi, i fragmenty brzmiące szablonowo. Niczego nie poprawia. Przy tym tekście już robocze przejście przed tym etapem znalazło słowo „silnik” użyte, zanim cokolwiek je wyjaśniło, i „budowanie”, które zamieniłem na zwykłe słowa.
- Sztuczny Miodek. Maszynowy skaner i osąd sprawdzają polszczyznę i ślady pisania „na autopilocie”: puste otwarcia, wyliczanki po trzy, przeciwstawienie dopisywane do każdego zdania. W tym tekście wyłapał dwa wyliczenia po trzy i jedno krótkie zdanie z kontrastem, które przepisałem. Narzędzie ma wynik PASS albo FAIL, a „PASS z uwagami” liczy się jako FAIL. Opis w ramce poniżej.
- Skan nazw. Szukam w tekście nazw klientów, pracodawców z ogłoszeń i roboczych nazw produktów. Klienci i pracodawcy z ogłoszeń pozostają anonimowi, także w opisach, po których dałoby się ich rozpoznać. Własny produkt wolno nazwać, ale z informacją, że jest mój, jak Gatefold w tym tekście. Dlatego piszę tu o „prawdziwym ogłoszeniu” i o „jednej z prawdziwych stron”.
- Liczby i daty w źródle. Każdą liczbę i datę sprawdzam w dokumencie, raporcie albo repozytorium, a w wersji angielskiej liczby muszą być te same co w polskiej. W tym tekście dotyczy to na przykład wyniku 3,3 procent odpowiedzi „nie wiem”, pokrycia 14 z 14, osiem lekcji w pięciu modułach i dat potwierdzenia faktów. Czego nie da się potwierdzić, nie trafia do tekstu jako fakt.
- Lista rzeczy do potwierdzenia. Wszystko, czego agent nie mógł sprawdzić, wypisuje na liście pytań do mnie. Przykład z tego tekstu: czy wolno przytoczyć moją uwagę o osobie czytającej piąte CV w pierwszej osobie, prawie słowo w słowo. Inny: kto dokładnie ułożył ogłoszenie dla dema. Źródło mówi tylko, że powstało z pozycjonowania mojego profilu, więc tekst milczy, dopóki nie odpowiem.
- Moja akceptacja i doba przerwy. Czytam tekst i decyduję o tezie i o faktach z listy. Od akceptacji do publikacji mija co najmniej 24 godziny i czytam jeszcze raz. Brak odpowiedzi z mojej strony nie oznacza zgody, więc żaden etap nie przechodzi dalej sam.
- Szkic w blogu i publikacja na polecenie. Tekst ląduje w blogu jako szkic roboczy. Publikuje się dopiero po moim wyraźnym poleceniu. Pod tekstem stoi oświadczenie, że szkic przygotowały agenty AI, a redakcję i sprawdzenie faktów zrobiłem ja. Jeśli po publikacji okaże się, że fakt lub liczba były błędne, poprawiam je i dopisuję na końcu notę z datą.